Sie haben ein Bild, das eine Idee festhält. Was wäre, wenn sich der See kräuselte, das Auto durch die Kurve fuhr oder die Kamera einer Schildkröte unter Wasser folgte? Ein kurzer Film kann neben dem Aussehen auch Atmosphäre und Tempo vermitteln. Er könnte eine Präsentation eröffnen, ein Werbekonzept weiterentwickeln oder zu einer Einstellung in einem längeren Schnitt werden.
Wir vergleichen drei Wege für diese Aufgabe: Wan2.2, LightWan2.2 und LTX-2.5. Jedes Modell erhält für seine Szene dasselbe Ausgangsbild und dieselbe Beschreibung der gewünschten Bewegung. Eine NVIDIA RTX PRO 6000 Blackwell Max-Q mit nominell 96 GB Grafikspeicher übernimmt die Berechnungen. Gefordert sind etwa 15 Sekunden lange Filme mit 1280 × 704 Pixeln und zur Umgebung passendem Ton.
Beginnen Sie mit einem dieser Motive: Hütte am See, Schotter-Rallye oder Schildkröte über einem Riff. Jede Szene wirft drei praktische Fragen auf: Passt die Bewegung zur Idee, wofür könnte das Ergebnis nützlich sein und wie lange dauert die Erstellung? Einstellungen zur Reproduktion und Messdetails stehen am Ende für alle, die tiefer einsteigen möchten.
Die wichtigsten Ergebnisse
LTX-2.5 lieferte in dieser Serie die schnellsten Ergebnisse: Die gemessene Bild-und-Ton-Phase dauerte 1.2–1.5 Minuten. LightWan2.2 benötigte 2.6–2.7 Minuten für den stummen Film; mit der separaten Tonphase ergab sich für jede Szene eine Summe von 3.8 Minuten. Wan2.2 mit anschließender Tonerzeugung benötigte 121.8–122.5 Minuten. Dies sind Messwerte von neun abgeschlossenen Filmen und sechs separaten Tonphasen, keine Vorhersagen für jede Aufgabe.
Die Geschwindigkeit entscheidet nicht, welcher Clip am besten zu einem Projekt passt. In den untersuchten Einzelbildern der Hüttenszene bewahren Wan und LightWan eine ähnlich ruhige Komposition, während LTX Nebel und Beleuchtung stärker verändert. Alle drei Rallye-Sequenzen deuten eine Rückkehr zu einem weiteren Manöver an, statt eine Kurve mit anschließender endgültiger Abfahrt zu zeigen. Die Schildkrötenbeispiele unterscheiden sich vor allem in Position, Beleuchtung und anatomischen Details. Dies sind Beobachtungen anhand ausgewählter Standbilder, keine Beurteilungen der vollständigen Bewegungsflüssigkeit oder des Tons.
Drei Varianten, zwei Modellfamilien
Bild-zu-Video-Generierung verbindet ein Standbild mit einer schriftlichen Beschreibung der Handlung. Das Bild liefert Aussehen und Komposition; der Text beschreibt, was als Nächstes geschehen soll: in welche Richtung das Auto fährt, ob die Kamera stillsteht und wie stark sich das Wasser bewegt. So entwickelt sich die Idee weiter, ohne jedes Objekt manuell zu animieren.
Das Ergebnis muss dennoch geprüft werden: Das Modell schlägt eine Entwicklung der Szene vor, statt einen präzisen 3D-Animationsplan auszuführen. Wan2.2 ist unser Referenzprofil. LightWan2.2 gehört zur gleichen Familie, ist aber für einen kürzeren Berechnungsablauf vorbereitet. LTX-2.5 steht für die zweite Familie und erzeugt im gewählten Profil Bild und Ton gemeinsam. Es sind drei praktische Konfigurationen aus zwei Modellfamilien, nicht drei voneinander unabhängige Modelle.
Alle drei Ausgangsillustrationen sind synthetisch und wurden außerhalb des Testservers erstellt. Es sind kreative Beispiele, keine Aufnahmen realer Immobilien, Wettbewerbe oder Tiere. Wan und LightWan werden mit 16 Bildern pro Sekunde wiedergegeben, LTX mit 24. Mehr Bilder können Bewegungen flüssiger erscheinen lassen; berücksichtigen Sie diesen Unterschied beim Vergleich.
Eine Hütte am See: Kann eine ruhige Szene ruhig bleiben?
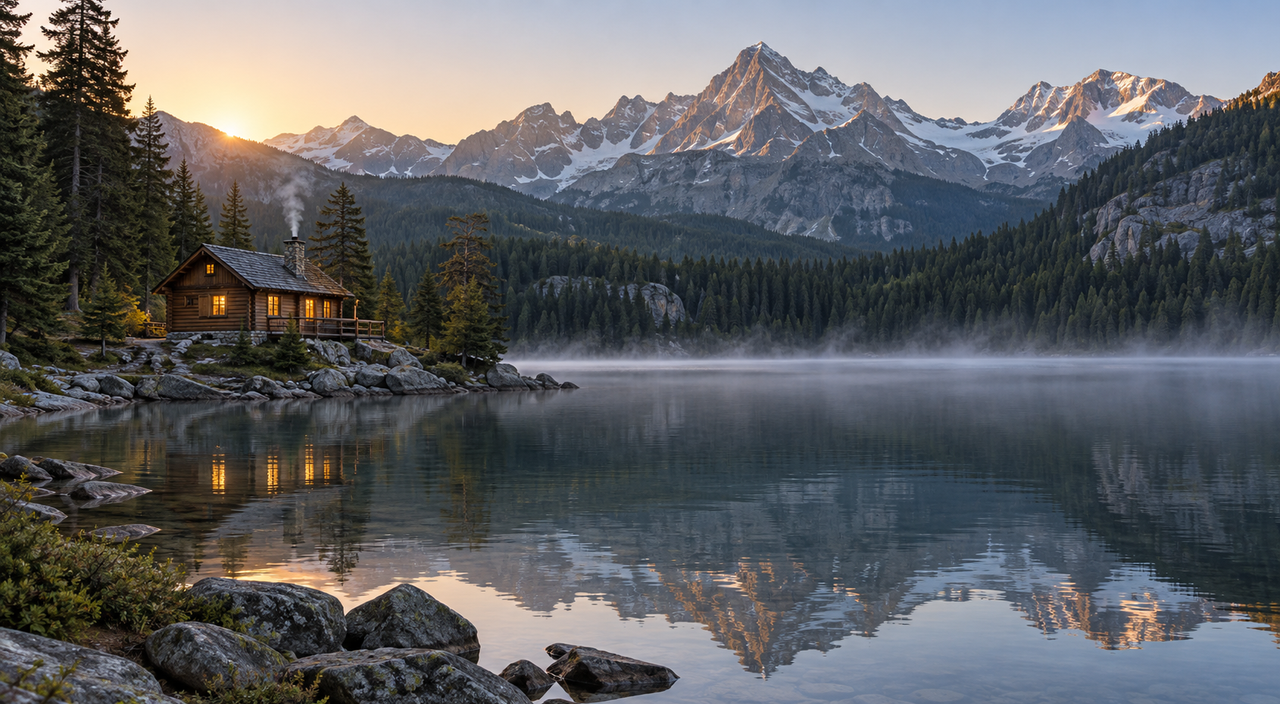
Die erste Szene verlangt zurückhaltende Bewegung. Das Wasser kräuselt sich, etwas Nebel zieht über den See und nahe Äste bewegen sich sanft. Die Kamera soll stillstehen. Hütte und Berge sollen vom Anfang bis zum Ende dieselben Objekte bleiben.
Denken Sie an eine Auftaktfolie für einen Rückzugsort, einen ruhigen Website-Hintergrund oder eine stille Passage in einem Werbefilm. Die Bewegung soll die Komposition beleben, ohne mit Titel oder Vortragenden zu konkurrieren. Eine ruhende Kamera und subtile Veränderungen der Umgebung sind hier wichtiger als ein aufwendiger Kameraflug.
Hütte in einer ruhigen Landschaft
Eingabebild
Jedes Video hat Ton. Starten Sie den gewünschten Clip über die Wiedergabeschaltfläche.
Clipdetails
1280 × 704 · 16 fps · Bilder: 241 · Seed: 104729
Clipdetails
1280 × 704 · 16 fps · Bilder: 241 · Seed: 104729
Clipdetails
1280 × 704 · 24 fps · Bilder: 361 · Seed: 104729
Ein einfacher Vergleich beginnt mit einem festen Punkt: einem Fenster, dem Dach oder dem Ufer. Betrachten Sie danach Nebel und Spiegelungen. So lässt sich gewünschte Bewegung besser von unbeabsichtigten Szenenänderungen trennen. Für den Ton ist dieselbe Zurückhaltung gewünscht: sanftes Wasser, eine leichte Brise und entfernte Vögel.
In den vom KI-Assistenten untersuchten Bildern halten Wan und LightWan die erkennbare Hütte, die Bergkontur und das Ufer an sehr ähnlichen Positionen. Änderungen konzentrieren sich auf Spiegelungen, Wellen und Kaminrauch. Bei LightWan ist am Ende eine ausgeprägtere, gewundene Rauchfahne zu sehen; bei Wan ist sie schmaler. Beide bewahren die warme Beleuchtung und leuchtenden Fenster, ohne dass in diesen Stichproben eine deutliche große Verformung des Gebäudes sichtbar wäre.
LTX geht freier mit der Atmosphäre um. Über dem See verdichtet sich der Nebel, und spätere Bilder wirken kühler und dunkler als das Ausgangsbild. Die Hütte bleibt erkennbar, entfernte Details werden jedoch weicher und die Komposition weniger konstant. Das deutet auf zwei unterschiedliche Bildrichtungen hin: Die Wan-Varianten bleiben näher an der ruhigen Ausgangskomposition, während LTX die Stimmung stärker verändert. Eine Standbildprüfung kann weder eine vollkommen fixierte Kamera noch flüssige Bewegung zwischen den Stichproben belegen.
Hinweise zum Ton (maschinelle Analyse):
- Wan2.2: Die reine Audioanalyse erkannte eine sanfte Melodie, die an Klavier oder Keyboard erinnerte, während die Analyse mit Video keinen hörbaren Ton meldete. Die Berichte widersprechen sich und bestätigen die gewünschten Geräusche am See nicht.
- LightWan2.2: Die reine Audioanalyse beschrieb einen gleichmäßigen, sanften Glockenklang, die Analyse mit Video erwähnte Musik. Die Berichte bestätigen weder Wasser noch Wind oder Vögel.
- LTX-2.5: Die reine Audioanalyse erkannte einen kontinuierlichen weichen Flächen- oder Bordunklang, der an elektronische Atmosphäre erinnerte. Der Bericht mit Video beschrieb die Landschaft ohne brauchbare Tonbeobachtungen und belegt daher nicht, ob der Ton zur Umgebung passt.
Ein Rallyeauto: Bewegung ist mehr als ein scharfes Einzelbild
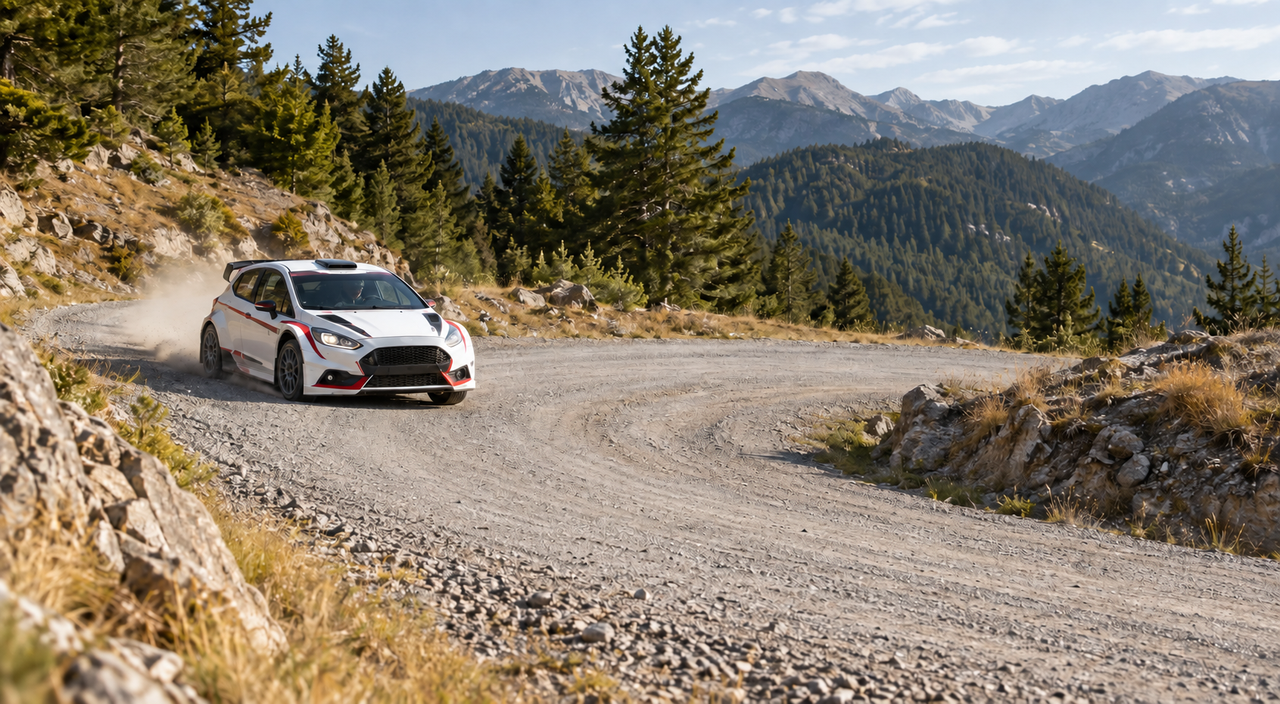
In der zweiten Szene soll ein markenloses Rallyeauto in eine Schotterkurve einfahren, kontrolliert driften, sich anschließend geradestellen und beschleunigen. Die Kamera folgt dem Fahrzeug. Räder, Staub und Fahrtrichtung müssen zusammenpassen.
Ein überzeugendes Einzelbild reicht für diese Aufgabe nicht aus. Das Auto muss während der Bewegung als dasselbe Fahrzeug erkennbar bleiben, mit plausiblem Kontakt zwischen Rädern und Fahrbahn. Der Staub sollte der Handlung folgen und nicht wie ein unabhängiger Effekt wirken.
Ein Auto in Bewegung
Eingabebild
Jedes Video hat Ton. Starten Sie den gewünschten Clip über die Wiedergabeschaltfläche.
Clipdetails
1280 × 704 · 16 fps · Bilder: 241 · Seed: 104729
Clipdetails
1280 × 704 · 16 fps · Bilder: 241 · Seed: 104729
Clipdetails
1280 × 704 · 24 fps · Bilder: 361 · Seed: 104729
Eine praktische Verwendung ist die bewegte Skizze eines Werbespots. Bevor ein Team eine vollständige Produktion plant, könnte es Kurve, Kamerabewegung und Ende der Einstellung erkunden. Ein Storyboard — der Plan aufeinanderfolgender Einstellungen — erhält ein Gefühl für Tempo, das ein Standbild nicht vermittelt.
Betrachten Sie Anfang, Mitte und Ende der Kurve getrennt. Gibt es eine klare Handlungsabfolge? Bleibt das Fahrzeug dasselbe Auto, mit Staub hinter sich? Schalten Sie dann den Ton ein: Wechselnde Motordrehzahlen, auf Schotter scharrende Reifen und aufgewirbelte Steine sollten das Geschehen unterstützen statt einen unabhängigen Hintergrund zu bilden.
Die Wan- und LightWan-Stichproben bewahren ein erkennbares weißes Auto mit rotem Streifen und zeigen Front-, Seiten- und Heckansichten mit Staub dahinter. Nach etwa 8–10 Sekunden erscheint das Auto wieder von vorn, nachdem es sich entfernt hatte: Die Stichproben deuten auf eine weitere Durchfahrt oder ein weiteres Manöver hin, nicht auf die gewünschte einzelne Kurve mit endgültiger Abfahrt. Bei LightWan verändern sich außerdem einige Heck- und Raddetails. Kennzeichen und kleine Markierungen sollten nicht als originalgetreue Fahrzeugdetails verstanden werden.
LTX interpretiert die Szene mit einer näheren Kameraverfolgung; das Auto nimmt zunehmend mehr Bildfläche ein. Auch seine Route führt zurück, eine spätere Durchfahrt erfolgt in entgegengesetzter Bildrichtung. Die weiß-rote Identität und der große Heckflügel bleiben deutlich, doch Streifen und Karosseriedetails ändern sich, während die Umgebung weich oder unscharf wirkt. Alle drei Ergebnisse können eine Diskussion über ein dynamisches Storyboard unterstützen; keines führt jedoch einfach die gesamte gewünschte Abfolge zu Ende. Die wiederkehrende Handlung stammt aus der Generierung; im Schnitt haben wir keine Schleife ergänzt. Standbilder belegen weder Raddrehung und Fahrphysik noch kontinuierliche Bewegung zwischen den Stichproben.
Hinweise zum Ton (maschinelle Analyse):
- Wan2.2: Ohne Video erkannte das Modell gegen Ende aufheulende Motoren und quietschende Reifen. Die Analyse mit Video ordnete diese Geräusche grob dem Auto zu, belegt jedoch keine präzise Synchronisation.
- LightWan2.2: Die reine Audioanalyse erkannte aufheulende Motoren und quietschende Reifen; die Analyse mit Video nannte Motorgeräusche und Wind lediglich als mögliche Geräusche. Die zeitliche Zuordnung zu konkreten Manövern wurde nicht bestätigt.
- LTX-2.5: Die reine Audioanalyse beschrieb einen Motor, dessen Klang von tiefem Summen zu höheren Drehzahlen anstieg. Der Bericht mit Video vergleicht keine einzelnen Geräuschereignisse mit den Manövern; daher beurteilen wir die präzise Synchronisation nicht.
Eine Schildkröte über einem Riff: Glaubwürdige Bewegung unter Wasser
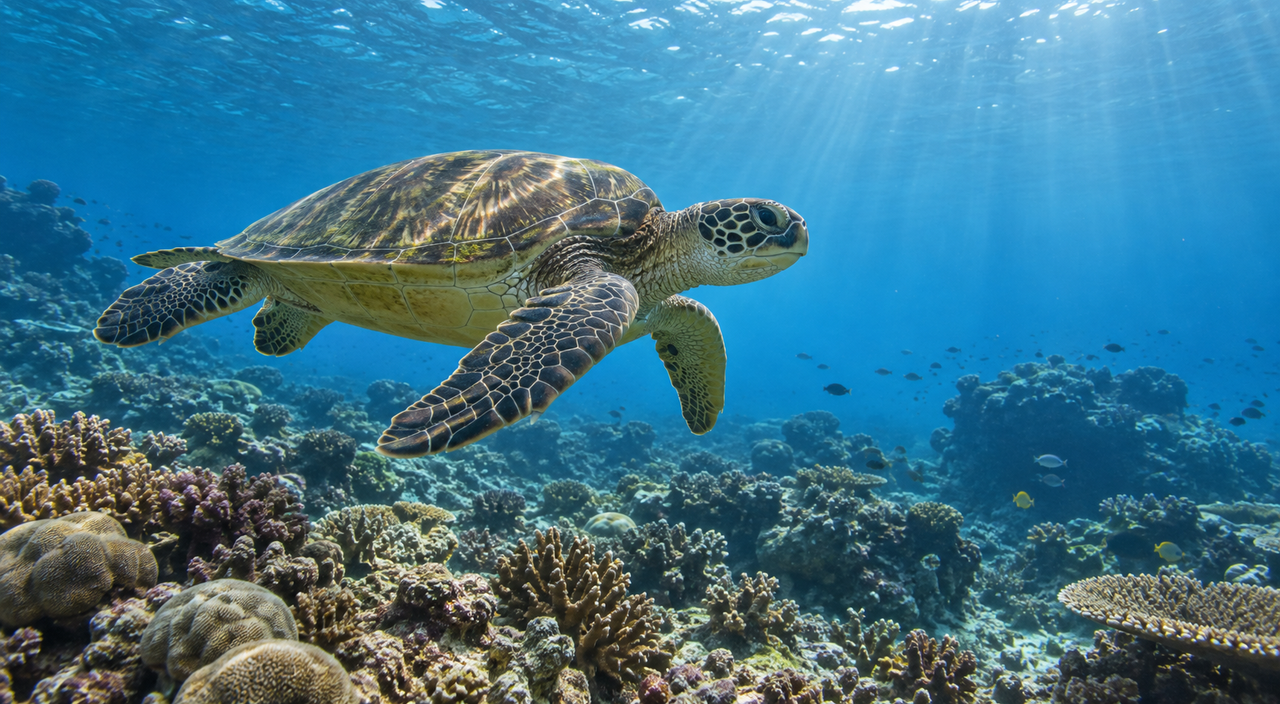
Die dritte Szene führt in eine andere Umgebung. Eine Meeresschildkröte soll über Korallen gleiten, mit Fischen in der Nähe, schwebenden Partikeln und wechselndem Sonnenlicht auf dem Meeresboden. Die Kamera soll sanft folgen, statt am Motiv vorbeizurasen.
Es geht nicht einfach darum, einen Blaustich hinzuzufügen. Eine konsistente Körperform, gemächliche Flossenbewegungen und ein Gefühl für den Abstand zwischen Schildkröte und Riff tragen zu einer glaubwürdigen Szene bei.
Eine Schildkröte unter Wasser
Eingabebild
Jedes Video hat Ton. Starten Sie den gewünschten Clip über die Wiedergabeschaltfläche.
Clipdetails
1280 × 704 · 16 fps · Bilder: 241 · Seed: 104729
Clipdetails
1280 × 704 · 16 fps · Bilder: 241 · Seed: 104729
Clipdetails
1280 × 704 · 24 fps · Bilder: 361 · Seed: 104729
Dies könnte eine illustrative Sequenz in einer Präsentation, ein Konzept für ein Bildungsprojekt oder ein ruhiger Übergang zwischen Filmabschnitten sein. Klare Bildebenen unterstützen die Idee: Die Schildkröte führt den Blick, während Riff, Fische und Licht ihre Umgebung bilden.
Verfolgen Sie eine vollständige Flossenbewegung und betrachten Sie danach den Hintergrund. Bewegen sich die Fische unabhängig? Ändert sich das Licht allmählich? Gewünscht ist eine gedämpfte Unterwasseratmosphäre — ein anderer Tonauftrag als die Brise und die Wellen am See.
LightWan bewahrt die helle türkisfarbene Komposition, Sonnenstrahlen und eine große Schildkröte nahe ihrer Ausgangsposition. Die Flossenstellungen unterscheiden sich in vielen Stichproben relativ wenig; um 11–12 Sekunden sind jedoch angehobene Flossen und ihre hellen Unterseiten sichtbar. Dies ist eine zurückhaltende Interpretation, keine Behauptung, das Bild sei eingefroren.
Wans Schildkröte entfernt sich etwas, mit stärkeren Änderungen der Vorderflossenstellung. Wasser und Vordergrund werden dunkler, einzelne Fische sind später schwerer zu erkennen. LTX bewahrt das helle Riff, doch die Schildkröte entfernt sich allmählich und dreht sich in eine seitliche Rückansicht. In späteren Stichproben wirkt die hintere Kontur oder die verdeckte abgewandte Flosse ungewöhnlich schmal und lang. Die Bilder belegen nicht, ob dies an der Perspektive oder einem Anatomiefehler liegt. In jedem Ergebnis bleibt eine Schildkröte erkennbar; eine Standbildprüfung kann jedoch weder einen korrekten vollständigen Schwimmzyklus noch unabhängiges Verhalten der Fische bestätigen.
Hinweise zum Ton (maschinelle Analyse):
- Wan2.2: Die reine Audioanalyse erkannte ein gleichmäßiges tiefes Grollen oder einen entfernten Motor; mit Video wurde derselbe Klang als bewegtes Wasser und mögliche Tieraktivität beschrieben. Dieser Widerspruch bestätigt weder natürliche Unterwassergeräusche noch ihre Synchronisation mit der Einstellung.
- LightWan2.2: Ohne Video beschrieb das Modell ein gleichmäßiges windähnliches Geräusch unklarer Herkunft; mit Video erkannte es Blasen und mögliche Geräusche von Meerestieren. Die geänderte Interpretation bestätigt weder diese Geräusche noch eine präzise Abstimmung auf die Handlung.
- LTX-2.5: Das Modell verband den Ton allein mit einem großen Motor im Leerlauf, beschrieb ihn mit Video jedoch als bewegtes Wasser. Die widersprüchlichen Berichte belegen weder natürliche Unterwasseratmosphäre noch präzise Synchronisation mit der Bewegung.
Ton, der zur Szene gehört
Wind am See, ein Motor in der Kurve und gedämpfte Unterwassergeräusche erfüllen unterschiedliche Zwecke. Wir verlangen Umgebungsgeräusche ohne Sprache oder Musik: Atmosphäre und einen Bezug zur sichtbaren Handlung. Dieselben Beispiele können daher in den polnischen und englischen Artikeln erscheinen, ohne die Sprache einer Erzählstimme wechseln zu müssen.
LTX erzeugt Bild und Ton gemeinsam. Wan und LightWan erzeugen zunächst einen stummen Film; LTX Retake ergänzt Umgebungsgeräusche, ohne das Originalbild zu verändern. Sie können zunächst die Bewegung bewerten und anschließend die Tonspur hinzufügen. Wir vergleichen vollständige Arbeitsabläufe; bei allen dreien stammt der Ton von LTX.
Die kurzen Tonbeschreibungen beruhen auf maschineller Analyse; die Bildhinweise auf ausgewählten, von einem KI-Assistenten geprüften Einzelbildern. Dies ist weder menschliches Anhören noch eine menschliche Prüfung der vollständigen Bewegung. Über die Player können Leser die gesamten Clips selbst vergleichen; die Methodik erläutert den Umfang unserer Bewertung. Die Vorgabe „keine Musik“ lenkt das Modell, garantiert aber kein entsprechendes Ergebnis.
Wie lange warten Sie auf einen fertigen Clip?
Fünfzehn Sekunden ist die Länge des Films. Seine Erstellung dauert separat — diese Zeit misst die Tabelle. Die Videoerstellungszeit reicht von der Modellvorbereitung bis zur gespeicherten Datei, nicht nur über die Generierungsschritte. Bei LTX umfasst sie den Ton; bei Wan und LightWan endet sie mit dem stummen Clip, die zusätzliche Tonphase wird gesondert aufgeführt.
Die Gesamtsumme addiert gemessene Phasen, nicht die vollständige Wartezeit eines Dienstes: Anwendungsstart, Warteschlangen und Bewertung des fertigen Materials sind ausgeschlossen.
| Szene | Variante | Videoerstellung [min] | Separater Ton [min] | Summe der Phasen [min] |
|---|---|---|---|---|
| Hütte am See | Wan2.2 | 121.3 | 1.2 | 122.5 |
| Hütte am See | LightWan2.2 | 2.6 | 1.1 | 3.8 |
| Hütte am See | LTX-2.5 | 1.5 | gemeinsam mit dem Video | 1.5 |
| Schotter-Rallye | Wan2.2 | 121.1 | 1.1 | 122.2 |
| Schotter-Rallye | LightWan2.2 | 2.7 | 1.1 | 3.8 |
| Schotter-Rallye | LTX-2.5 | 1.2 | gemeinsam mit dem Video | 1.2 |
| Schildkröte über einem Riff | Wan2.2 | 120.7 | 1.1 | 121.8 |
| Schildkröte über einem Riff | LightWan2.2 | 2.7 | 1.1 | 3.8 |
| Schildkröte über einem Riff | LTX-2.5 | 1.3 | gemeinsam mit dem Video | 1.3 |
Beim Erkunden einer Idee ist die Wartezeit auf den ersten Film hilfreich. Für ein vorzeigbares Ergebnis zählt die Summe aus Video und Ton. Das sind unterschiedliche Teile des kreativen Prozesses: zunächst eine zum Projekt passende Bewegung auswählen, dann die vollständige Einstellung bewerten. Die Tabelle enthält keine Zeit für Sichtung, Schnitt oder einen weiteren Versuch.
Wie viel Rechenaufwand steckt in einer Sekunde Video?
Die Gesamtzeit eines Clips zeigt, wie lange wir auf das Ergebnis gewartet haben. Eine weitere nützliche Sichtweise ist der Aufwand pro Sekunde fertigen Materials. Beispielsweise bedeuten 15.1 s in der Tabelle ungefähr fünfzehn Sekunden Berechnung für eine Sekunde Video mit Ton — nicht einen fünfzehn Sekunden langen Clip.
Wir berechnen diese Werte über die drei Szenen jeder Variante: die Summe der gemessenen Video- und Tonzeiten, geteilt durch die gemeinsame Videodauer oder Bildanzahl. Die Modellvorbereitung für jeden Auftrag bleibt enthalten. Es sind aus abgeschlossenen Läufen abgeleitete Verhältnisse, keine separaten Messungen der Erzeugung eines einzelnen Bildes.
| Variante | Wiedergabebildrate [fps] | Zeit pro 1 s Video mit Ton [s] | Durchschnitt pro Bild [s] |
|---|---|---|---|
| Wan2.2 | 16 | 486.7 | 30.4 |
| LightWan2.2 | 16 | 15.1 | 0.9 |
| LTX-2.5 | 24 | 5.2 | 0.2 |
Für die alltägliche Planung sind die Zeit für den gesamten Clip und die Zeit pro Sekunde Material am einfachsten nutzbar. Das Verhältnis pro Bild ist ergänzend: LTX erzeugt pro Wiedergabesekunde mehr Bilder als die anderen Varianten. Keiner dieser Werte bewertet Bildqualität, natürliche Bewegung oder die Eignung einer Einstellung für einen Schnitt.
Fünf Minuten mit 30 fps: Was lässt sich abschätzen?
Ein fünfminütiger Film mit 30 fps enthält 9000 Bilder. Einen solchen Film haben wir in dieser Serie nicht erzeugt; die gemessenen Clips laufen mit 16 oder 24 fps. Die folgende Tabelle ist nur eine ungefähre arithmetische Hochrechnung auf 9000 Bilder bei angenommenem proportionalem Rechenaufwand und ähnlichen Einstellungen mit 1280 × 704. Sie ist weder ein 30-fps-Benchmark noch eine Bestätigung, dass ein bestimmtes Profil diese Ausgabe unterstützt.
| Variante | Arithmetische Schätzung für 9000 Bilder mit Ton |
|---|---|
| Wan2.2 | etwa 76 Stunden |
| LightWan2.2 | etwa 2–2.5 Stunden |
| LTX-2.5 | etwa 30–40 Minuten |
Wir nehmen viele kurze Einstellungen an, keine durchgehende fünfminütige Generierung. Schnitt, Bewertung, Warteschlangen und wiederholte Versuche sind ausgeschlossen. Längere Aufträge können andere Speichermengen benötigen und anders skalieren; ihre tatsächliche Laufzeit erfordert daher einen gesonderten Test.
Eine Datei einfach mit 30 fps zu speichern bedeutet nicht, dass mehr Bilder erzeugt wurden: Bei derselben Bildfolge kann dies lediglich die Wiedergabe beschleunigen. Zwischenbilder zwischen vorhandenen Bildern zu erstellen ist ein anderer, zusätzlicher Prozess. Diesen haben wir hier nicht gemessen; die Tabelle beschreibt daher nicht dessen Laufzeit. Weniger Bilder zu erzeugen und die Ausgabe anschließend auf 30 fps zu bringen, erfordert eine eigene Messung.
Speicher: Wie viel GPU-Speicher benötigt der Auftrag?
Der Testrechner hat 96 GB System-RAM. Seine GPU besitzt separat 96 GB Grafikspeicher, meist VRAM genannt. Das sind unterschiedliche Ressourcen, kein austauschbarer Pool von 192 GB. System-RAM unterstützt Anwendung und Betriebssystem; VRAM hält Daten für die Berechnungen der Grafikkarte.
Die Tabelle zeigt die höchste beobachtete GPU-Speichernutzung, getrennt für die Video- und die nachfolgende Tonphase. GiB ist die von den Messwerkzeugen ausgegebene Einheit; GB bezeichnet die nominelle Hardwarekapazität.
| Szene | Variante | VRAM: Video [GiB] | VRAM: separater Ton [GiB] |
|---|---|---|---|
| Hütte am See | Wan2.2 | 81.1 | 77.7 |
| Hütte am See | LightWan2.2 | 53 | 77.7 |
| Hütte am See | LTX-2.5 | 29.2 | gemeinsam mit dem Video |
| Schotter-Rallye | Wan2.2 | 81.1 | 77.7 |
| Schotter-Rallye | LightWan2.2 | 53 | 77.7 |
| Schotter-Rallye | LTX-2.5 | 29.2 | gemeinsam mit dem Video |
| Schildkröte über einem Riff | Wan2.2 | 81.1 | 77.7 |
| Schildkröte über einem Riff | LightWan2.2 | 53 | 77.7 |
| Schildkröte über einem Riff | LTX-2.5 | 29.2 | gemeinsam mit dem Video |
Die Speicherwerte von Video und separatem Ton werden hier nicht addiert: Die Phasen laufen nacheinander, nicht gleichzeitig. Beachten Sie, dass LightWans separate Tonphase mehr VRAM nutzt als seine Videophase. Zusätzliche Energiemessungen stehen in den aufklappbaren technischen Details.
Einen nützlichen Ausgangspunkt wählen
Beginnen Sie mit der Aufgabe, nicht mit dem Modellnamen. Wer eine Werbeidee erkundet, braucht möglicherweise vor allem schnelle Entwürfe. Für einen ruhigen Filmeinstieg steht die Komposition im Mittelpunkt. Bei einer Sportsequenz kann eine klare Handlungsentwicklung wichtiger sein als die Details eines einzelnen Bildes.
Wenn es vor allem darum geht, eine Idee schnell mit Bild und Ton zu erkunden, hat LTX in dieser Serie die kürzeste gemessene Phase: 1.2–1.5 Minuten. Es kann sich jedoch weiter von Ausgangsbeleuchtung und Komposition entfernen, wie bei der Hütte, oder eine sorgfältige Anatomieprüfung erfordern, wie bei der Schildkröte. Die kurze Wartezeit liefert früher etwas zur Bewertung, aber keine automatische Freigabe für eine fertige Produktion.
LightWan ist hier ein praktischer Ausgangspunkt für schnelle stumme Entwürfe: 2.6–2.7 Minuten beziehungsweise 3.8 Minuten als Phasensumme mit Ton. Seine Hüttensamples bewahren eine ähnlich zurückhaltende Komposition wie Wan, und seine Schildkröte bleibt nahe am hellen Ausgangsbild. Die separate Tonerzeugung erhöht die beobachtete VRAM-Nutzung allerdings von 53 GiB für den Film auf 77.7 GiB während Retake. Die Ressourcenplanung muss deshalb den gesamten Ablauf abdecken, nicht nur die schnelle Videophase.
Wans Konfiguration bedeutet mehr als zwei Stunden gemessener Phasen pro Szene. Dieser Aufwand sollte durch eine konkret gesuchte Eigenschaft des Ergebnisses gerechtfertigt sein, nicht durch die Annahme, längere Berechnungen ergäben einen besseren Film. Bei der Rallye zeigt in diesen Stichproben keine der drei Varianten ein eindeutiges, zur Vorgabe passendes Ende. Ein präzise geplanter Autowerbespot würde daher eine gesonderte Prüfung der gesamten Handlung und Fahrzeuggeometrie benötigen. Diese Beispiele eignen sich vor allem zum Konzeptvergleich, nicht als fertige Referenzen für originalgetreue Produktanimation.
Ein dedizierter GPU-Server bietet einen Arbeitsplatz für verschiedene Varianten und die Kontrolle ihrer Einstellungen. Ein sinnvoller nächster Schritt ist ein repräsentatives Bild mit einer einfachen Vorgabe: eine Motivbewegung, eine festgelegte Kameraposition und ein klares Ende. So lässt sich leichter beurteilen, ob der Clip das Projekt einem nutzbaren Ergebnis näherbringt.
Planen Sie ähnliche Experimente? Entdecken Sie die Serverkonfiguration für Videoaufgaben. Diese Ergebnisse beschreiben konkrete Einstellungen und Beispiele, keine garantierte Fertigstellungszeit für jedes Projekt.
Praktische Fragen
Für kürzere Einstellungen und den Einfluss der Auflösung lesen Sie unseren früheren Wan2.2-Test mit 480p und 720p. Er untersucht andere Motive: Produkte und einen Innenraum. Dieser Vergleich konzentriert sich auf längere Szenen, unterschiedliche Generierungsabläufe und Ton.
Kann aus einem guten Clip ein fünfminütiger Film werden?
Ein längerer Film lässt sich als mehrere Einstellungen mit anschließendem Schnitt planen, doch dieser Vergleich belegt keine fünfminütige Generierung in einer einzigen Einstellung. Dieselbe Figur oder dasselbe Objekt über mehrere Einstellungen hinweg beizubehalten verursacht zusätzlichen Aufwand. Die Multiplikation eines Zeitwerts für 15 Sekunden ist keine verlässliche Fertigstellungsschätzung für eine solche Produktion.
Behält ein Produkt sein genaues Aussehen?
Das muss am Ergebnis geprüft werden. Logos, kleine Details, Geometrie und Bewegung können für eine kommerzielle Produktpräsentation wichtig sein. Ein attraktives Konzept ist nicht automatisch eine genaue Darstellung des verkauften Gegenstands.
Was gilt für die kommerzielle Nutzung?
Wans Code und die auf eine feste Version bezogene LightWan-Modellkarte nennen Apache-2.0. Prüfen Sie auch die Lizenzen der tatsächlich verwendeten Gewichte und Zusatzkomponenten.
LTX-2.5 verwendet die LTX-2.x Community License, wie im Repository angegeben. Kommerzielle Nutzung erfordert ab einem Jahresumsatz von mindestens US$10 Millionen eine kostenpflichtige Lizenz; einbezogen sind Unternehmen gemäß der dortigen Definition gemeinsamer Kontrolle. Unterhalb dieser Schwelle gelten weiterhin weitere Bedingungen, auch für Retake-Audio. Diese Zusammenfassung stellt keine Berechtigung eines Unternehmens fest: Prüfen Sie vor dem Einsatz die Bedingungen für den beabsichtigten Nutzungszweck, Vertrieb oder Dienst.
Technische Details
Dieser Abschnitt bündelt Methodik und Einstellungen zur Reproduktion des Vergleichs.
Eingaben, Profile und ein Ergebnis pro Aufgabe
Der Vergleich umfasst drei Szenen und drei Varianten: einen fertigen Film pro Kombination, insgesamt neun Clips. Wan und LightWan erhalten anschließend sechs separat gemessene Tonphasen. Probeläufe prüfen die Funktionsfähigkeit des Aufbaus und sind von den Endergebnissen ausgeschlossen. Die Tabellen enthalten nur abgeschlossene Läufe; ein vor Erstellung einer gültigen Datei abgebrochener Lauf wird mit denselben Einstellungen wiederholt, wobei seine Protokolle erhalten bleiben. Wir wählen nicht stillschweigend den schönsten Clip aus mehreren Versuchen. Ein Lauf zeigt ein Ergebnis, keinen Durchschnitt, Median oder die Streuung zwischen Läufen.
Innerhalb jeder Szene teilen die Varianten ein normalisiertes PNG mit 1280 × 704, die Hauptbeschreibung und Seed 104729. Die Generierungssteuerung funktioniert nicht über alle Architekturen hinweg gleich. Wan erhält zusätzlich einen negativen Prompt: eine Liste unerwünschter Bildeigenschaften. Die gewählten destillierten LightWan- und LTX-Profile verwenden keinen. Der Seed dokumentiert eine zufällige Anfangswahl, nicht identisches Rauschen zwischen Modellen oder bytegleiche Ausgabe auf einem anderen Softwarestack. Exakte Coderevisionen, Gewichte und Einstellungen gehören in den Reproduktionsnachweis.
| Variante | Berechnungsprofil | Bilder und Wiedergabe | Audio |
|---|---|---|---|
| Wan2.2 | I2V-A14B, 20 Schritte, FP16-Diffusionsexperten; UMT5-Textencoder mit skaliertem FP8 | 241 Bilder, 16 fps | Separates LTX Retake |
| LightWan2.2 | 4 Schritte, destilliertes NVFP4-Diffusionsprofil, Sparse Attention | 241 Bilder, 16 fps | Separates LTX Retake |
| LTX-2.5 | Destilliertes NVFP4-Transformerprofil, 8 Schritte mit 640 × 352 und 3 Verfeinerungsschritte mit 1280 × 704 | 361 Bilder, 24 fps | Gemeinsam mit dem Bild |
LTX verwendet eine räumliche Vergrößerung zwischen den Phasen und einen Conv-VAE-Decoder. Zu den Referenzen gehören die Wan-Dokumentation, LightWan-Konfiguration und LTX-Pipeline. Schritte sind keine austauschbaren Arbeitseinheiten: 20 durch vier zu teilen sagt weder Geschwindigkeit noch Qualität voraus. Verglichen werden vollständige Konfigurationen, nicht die Wirkung einer einzelnen Option.
Die Sampling-Einstellungen für Wan in der finalen Serie wurden während der Vorbereitung anhand der festgelegten offiziellen Vorlage fixiert: Euler/simple, 20 Schritte, CFG 3.5, Shift 8 und eine Aufteilung von 10 + 10 zwischen den Experten. Wir fordern 241 statt der in der Vorlage verwendeten 81 Bilder an und testen damit eine längere Einstellung. Das sind Einstellungen, kein Beleg ihrer Wirkung auf eine bestimmte Bildeigenschaft. FP16 bezeichnet Wans Diffusionsexperten, nicht den gesamten Softwarestack. Ebenso bedeutet NVFP4 nicht, dass jede Komponente von LightWan oder LTX mit vier Bit arbeitet.
Die für die Reproduktion erforderlichen Details sind verlinkt in protocol.json und workflows.json: Softwareversionen, Abhängigkeiten, Einstellungen und Prüfsummen. Sie beschreiben auch Kompatibilitätsänderungen in einer separaten Build-Kopie. Originalquellen und Änderungshistorie bleiben erhalten.
Bei der Vorbereitung der Wiedergabedateien wird der MP4-Header vereinheitlicht, ohne das Video neu zu kodieren. Exakte Vergleiche von Paketen, Zeitstempeln und jedem dekodierten Bild bestätigen, dass Film und Wiedergabegeschwindigkeit unverändert bleiben; die Quelldateien werden aufbewahrt.
Die nativen Ausgaben enthalten 241 Bilder mit 16 fps für Wan/LightWan und 361 Bilder mit 24 fps für LTX. Für die Anzeige gerundet sind sie 15.1 beziehungsweise 15 Sekunden lang. Das Raster beträgt 1280 × 704, nicht volle 1280 × 720. Die Clips werden nicht durch Schleifen, Interpolation, wiederholte Bilder, Zusammenfügen oder geänderte Wiedergabegeschwindigkeit verlängert.
Zeitmessgrenzen und Herkunft des Tons
Jeder finale Clip startet in einem neuen Anwendungsprozess, ohne ein vom vorherigen Auftrag beibehaltenes Modell. Der Dateicache des Betriebssystems wird nicht geleert. Auch Caches kompilierter GPU-Kernel, die während der Probeläufe gefüllt worden sein können, bleiben erhalten. Das ist weder der erste Lauf in einer frisch installierten Umgebung noch die Antwortzeit einer bereits geladenen Produktions-API. Die summierten Phasenzeiten schließen Warteschlangen und Lücken zwischen Aufgaben aus.
Die Zeitmessung umfasst Modellvorbereitung, Verarbeitung von Ausgangsbild und Beschreibung, Generierung, Umwandlung der Modellausgabe in Bilder und Speichern der MP4-Datei. Erstellung der Ausgangsillustrationen, Download der Gewichte, Programmstart und Bibliotheksimporte, umfangreiche Dateiprüfung und abschließende Medienbewertung sind ausgeschlossen. Ein geringer Verwaltungsaufwand bleibt im Messintervall enthalten. Das Erzeugen eines Modellobjekts im Programm lädt nicht zwangsläufig alle seine Daten; Teile können später gelesen werden. Die separate Retake-Messung umfasst Modellvorbereitung, Tonerzeugung, erforderliche Verarbeitung — einschließlich Videodekodierung mit verworfener Ausgabe —, Speichern des ursprünglichen WAV, Signalprüfungen, AAC-Kodierung und Zusammenführen der Spuren.
Retake erhält für jede Szene eine eigene Geräuschbeschreibung. Seine Eingabebilder, Bildanzahl und Textvorgaben unterscheiden sich von der gemeinsamen LTX-Generierung; die Ergebnisse isolieren deshalb nicht allein die Methode der Tonerzeugung.
Das Hinzufügen von Ton durch LTX Retake lässt das Originalbild unverändert. Dem Videozweig des Modells wird kein zusätzliches Rauschen zugeführt; die finale MP4 verwendet den ursprünglichen Videostream statt der internen Retake-Rekonstruktion. Wir prüfen Pakete, Zeitstempel und dekodierte Bilder und bewahren sowohl den stummen Film als auch das unveränderte generierte WAV auf. Der Ton darf auf natürliche Weise bis zu 40 ms vor dem Bild enden; der tatsächliche Abstand wird dokumentiert, ohne Stille hinzuzufügen oder den Film zu kürzen. Läuft der Ton länger, darf beim Zusammenführen nur ein überstehendes Ende von bis zu 0.5 Sekunden abgeschnitten werden.
In jeder der sechs separaten Tonphasen endet die erzeugte Wellenform 12.5 ms vor dem Bild. Wir haben diesen natürlichen Unterschied beibehalten, ohne Stille einzufügen, den Ton zu strecken oder seine Verstärkung zu ändern.
Energieverbrauch berechnen und Ergebnisse prüfen
Der Energieverbrauch bleibt eine zusätzliche Messgröße für Leser, die die Hardwarelast untersuchen. Wattstunden, kurz Wh, beziehen sich auf die GPU-Platine, nicht auf den gesamten Server oder seine Stromrechnung. Als Referenz stellt die folgende Tabelle sie der Speichernutzung derselben Läufe gegenüber.
| Szene | Variante | VRAM: Video [GiB] | VRAM: separater Ton [GiB] | GPU-Energie: Summe [Wh] |
|---|---|---|---|---|
| Hütte am See | Wan2.2 | 81.1 | 77.7 | 607.7 |
| Hütte am See | LightWan2.2 | 53 | 77.7 | 16.2 |
| Hütte am See | LTX-2.5 | 29.2 | gemeinsam mit dem Video | 4.9 |
| Schotter-Rallye | Wan2.2 | 81.1 | 77.7 | 606.4 |
| Schotter-Rallye | LightWan2.2 | 53 | 77.7 | 16.2 |
| Schotter-Rallye | LTX-2.5 | 29.2 | gemeinsam mit dem Video | 4.5 |
| Schildkröte über einem Riff | Wan2.2 | 81.1 | 77.7 | 606.2 |
| Schildkröte über einem Riff | LightWan2.2 | 53 | 77.7 | 16.3 |
| Schildkröte über einem Riff | LTX-2.5 | 29.2 | gemeinsam mit dem Video | 4.7 |
Die Zeitverhältnisse im Hauptartikel verwenden ungerundete Phasenzeiten und die aus Bildanzahl und Bildrate berechnete Dauer. Für jede Variante summieren wir alle drei Szenen, teilen durch ihre gemeinsame Dauer oder Bildanzahl und runden erst dann auf eine Nachkommastelle. Die durchschnittliche Zeit pro Bild umfasst daher Modellvorbereitung und Ton; sie ist weder Einzelbildlatenz noch Wiedergabegeschwindigkeit.
Die Schätzung für 9000 Bilder setzt linearen Videoaufwand voraus. Beim separaten Ton verglichen wir eine Skalierung nach Videodauer mit der einfacheren Alternative, die gesamte gemessene Zeit nach Bildanzahl zu skalieren. Daraus ergibt sich LightWans breiterer Richtwertbereich; Retake verarbeitet auch Eingabebilder, daher ist keiner der Ansätze eine validierte Prognose. Für LTX mit gemeinsam erzeugtem Bild und Ton verwenden wir die vollständige Phasenzeit. Die grob gerundeten Werte sind weder Konfidenzintervalle noch garantierte Laufzeitgrenzen.
Der Energieverbrauch ergibt sich aus GPU-Leistungsmessungen während derselben Phase, deren Zeit in der Tabelle steht. Wir nehmen einen linearen Leistungsverlauf zwischen den Messpunkten an: technisch eine Trapezintegration mit interpolierten Grenzen. Messpunkte müssen Anfang und Ende abdecken; keine Lücke darf länger als 5 Sekunden sein, andernfalls wird Energie als nicht verfügbar markiert. Der VRAM-Spitzenwert stammt aus Messpunkten dieser Phase einschließlich der Punkte beiderseits ihrer Grenzen. Ein sehr kurzer Speicheranstieg zwischen Messpunkten kann unentdeckt bleiben. Ein GiB entspricht 2³⁰ Bytes.
Die Energie der GPU-Platine schließt CPU, Lüfter, Speicherlaufwerke und Netzteilverluste aus. Hat eine Phase keinen gültigen Messwert, bleibt die Video-plus-Ton-Summe nicht verfügbar statt null zu werden. Werte werden mit voller Genauigkeit addiert und anschließend mit höchstens einer Nachkommastelle angezeigt; daher kann die Summe angezeigter Einzelwerte geringfügig von der angezeigten Gesamtsumme abweichen. Auch Minuten und Sekunden werden unabhängig aus den Originalmessungen gerundet.
Systemweites RAM, Prozessspeicher und Allokationszähler des Frameworks sind unterschiedliche Messgrößen. Wans Host-RAM-Beobachtung nutzt tatsächliche auftragsspezifische Stichproben innerhalb des Messintervalls; fehlende Stichproben werden weder durch ein konfiguriertes Speicherlimit noch durch einen Allokationszähler ersetzt.
Ein akzeptiertes Ergebnis erfordert bestätigten Abschluss, gestoppte Rechenlasten, eine abgeschlossene kontrollierte Abkühlung, passende Eingaben und Einstellungen sowie aufbewahrte Dateien mit geprüften Hashes. Diese Prüfungen belegen einen abgeschlossenen Lauf und Dateiintegrität, unabhängig von der inhaltlichen Bewertung.
Wie wir Bild und Ton bewertet haben
Qwen2.5-Omni-7B analysierte zuerst den Ton allein, ohne Bild oder Hinweis auf die beabsichtigte Szene. In einem separaten Durchgang analysierte es den Ton zusammen mit zwei Videobildern pro Sekunde. Die Fragen betrafen erkennbare Geräusche, ihren Bildbezug, mögliche Sprache oder Musik und Unsicherheiten. Dies sind zwei getrennte Analysen desselben Modells, nicht zwei Expertenmeinungen.
Ein KI-Assistent prüfte zusätzlich Standbilder: eines pro Sekunde vom Beginn bis zur vierzehnten Sekunde sowie ein Bild in voller Auflösung bei 14 Sekunden. Die Beschreibungen betreffen sichtbare Objekte und Änderungen von Form und Komposition. Die Szenenhinweise trennen diese Beobachtungen vom Tonbericht.
Dies ist weder menschliches Anhören noch eine Betrachtung der vollständigen Bewegung. Ausgewählte Bilder können keine präzise Synchronisation jedes Geräuschs belegen. Das Modell kann Ereignisse übersehen oder falsch identifizieren; sein Bericht garantiert daher nicht das Fehlen von Sprache, Musik oder Fehlern. Die Eignung für ein konkretes Projekt erfordert weiterhin eine Prüfung des vollständigen Clips.
Das Verfahren und der abgeschlossene Bewertungsumfang sind verlinkt in review-method.json. Die Bewertung erfolgt außerhalb der Generierungszeitmessung und wird der Clip-Erstellungszeit in der Tabelle nicht zugerechnet. Widersprüche zwischen den Berichten bleiben erhalten: Ein im Bild beschriebenes Ereignis beweist nicht, dass dasselbe Ereignis hörbar ist.
Ein kurzes Glossar
I2V bedeutet aus einem Bild generiertes Video. Bilder pro Sekunde beschreiben die Wiedergabe; ein Schritt ist Teil der Modellberechnung. VRAM ist der GPU-Speicher. Destillation bereitet ein Modell auf weniger Berechnungsschritte vor; Quantisierung speichert manche Zahlen kompakter. Sparse Attention reduziert ausgewählte interne Berechnungen von Beziehungen. Ein Textencoder wandelt die Beschreibung in Modelldaten um; ein Decoder überführt die interne Darstellung in sichtbare Bilder oder Ton.