Kann ein lokales Modell eine Programmieraufgabe ebenso erfolgreich lösen wie ein kostenpflichtiger Dienst? In unserem früheren Test bestanden Qwen3.8-Flash-Next und GPT-6 Astra jeweils 15 von 15 Versuchen. Wir untersuchen, was dieser Gleichstand für die Wahl eines Modells zum Programmieren bedeutet. Das Ergebnis umfasst fünf Aufgaben mit je drei Wiederholungen. Es belegt nicht, dass die Modelle insgesamt gleich leistungsfähig sind.
Was genau testen wir?
Wir erstellten kleine Aufgaben aus der Anwendungsentwicklung: Datumsverarbeitung, Datenexport, die Reaktion eines Diagramms auf Mausbewegungen, Refactoring von Rechnungscode und Tests zur Fehlererkennung. Jede Aufgabe hatte einen festgelegten Umfang und Abnahmeprüfungen. Zum Bestehen mussten alle Prüfungen erfüllt sein. Teilweise korrekter Code reichte nicht aus.
Unsere Referenz war GPT-6 Astra, verwendet über Codex mit dem Reasoning-Aufwand xhigh. Das Modell lief im OpenAI-Dienst, Dateioperationen und Tests dagegen lokal unter Linux. Qwen lief auf unserem Server mit einer NVIDIA RTX PRO 6000 Blackwell Max-Q und 96 GB GPU-Speicher.
Dies war ein Agententest: Das Modell hatte Werkzeuge. Es konnte Dateien lesen, Code ändern, Befehle ausführen und seine Lösung nach der Prüfung überarbeiten. Das unterscheidet sich von der Erzeugung fertigen Codes in einer einzigen Antwort.
Jede Konfiguration erhielt dieselben fünf Aufgaben mit je drei Versuchen und einem Sitzungslimit von 20 Minuten. Wir behielten alle bewerteten Ergebnisse bei. Die Reihen liefen zu unterschiedlichen Zeiten und mit unterschiedlichen Konfigurationen; verglichen werden daher funktionierende Kombinationen aus Modellen und Werkzeugen. Frühere Fehler im Material und in der Bewertungssoftware wurden dokumentiert korrigiert und die Korrekturen einheitlich auf die bewerteten Lösungen angewandt.
Ergebnisse der fünf Aufgaben
Bezeichnungen wie 27B und 122B stehen für ungefähr Milliarden Parameter, nicht Gigabyte. Q4, Q5 und Q8 beschreiben Speicherformate der Gewichte. Geringere Genauigkeit spart Speicher; ihr Einfluss auf Ergebnisse muss an der Aufgabe getestet werden.
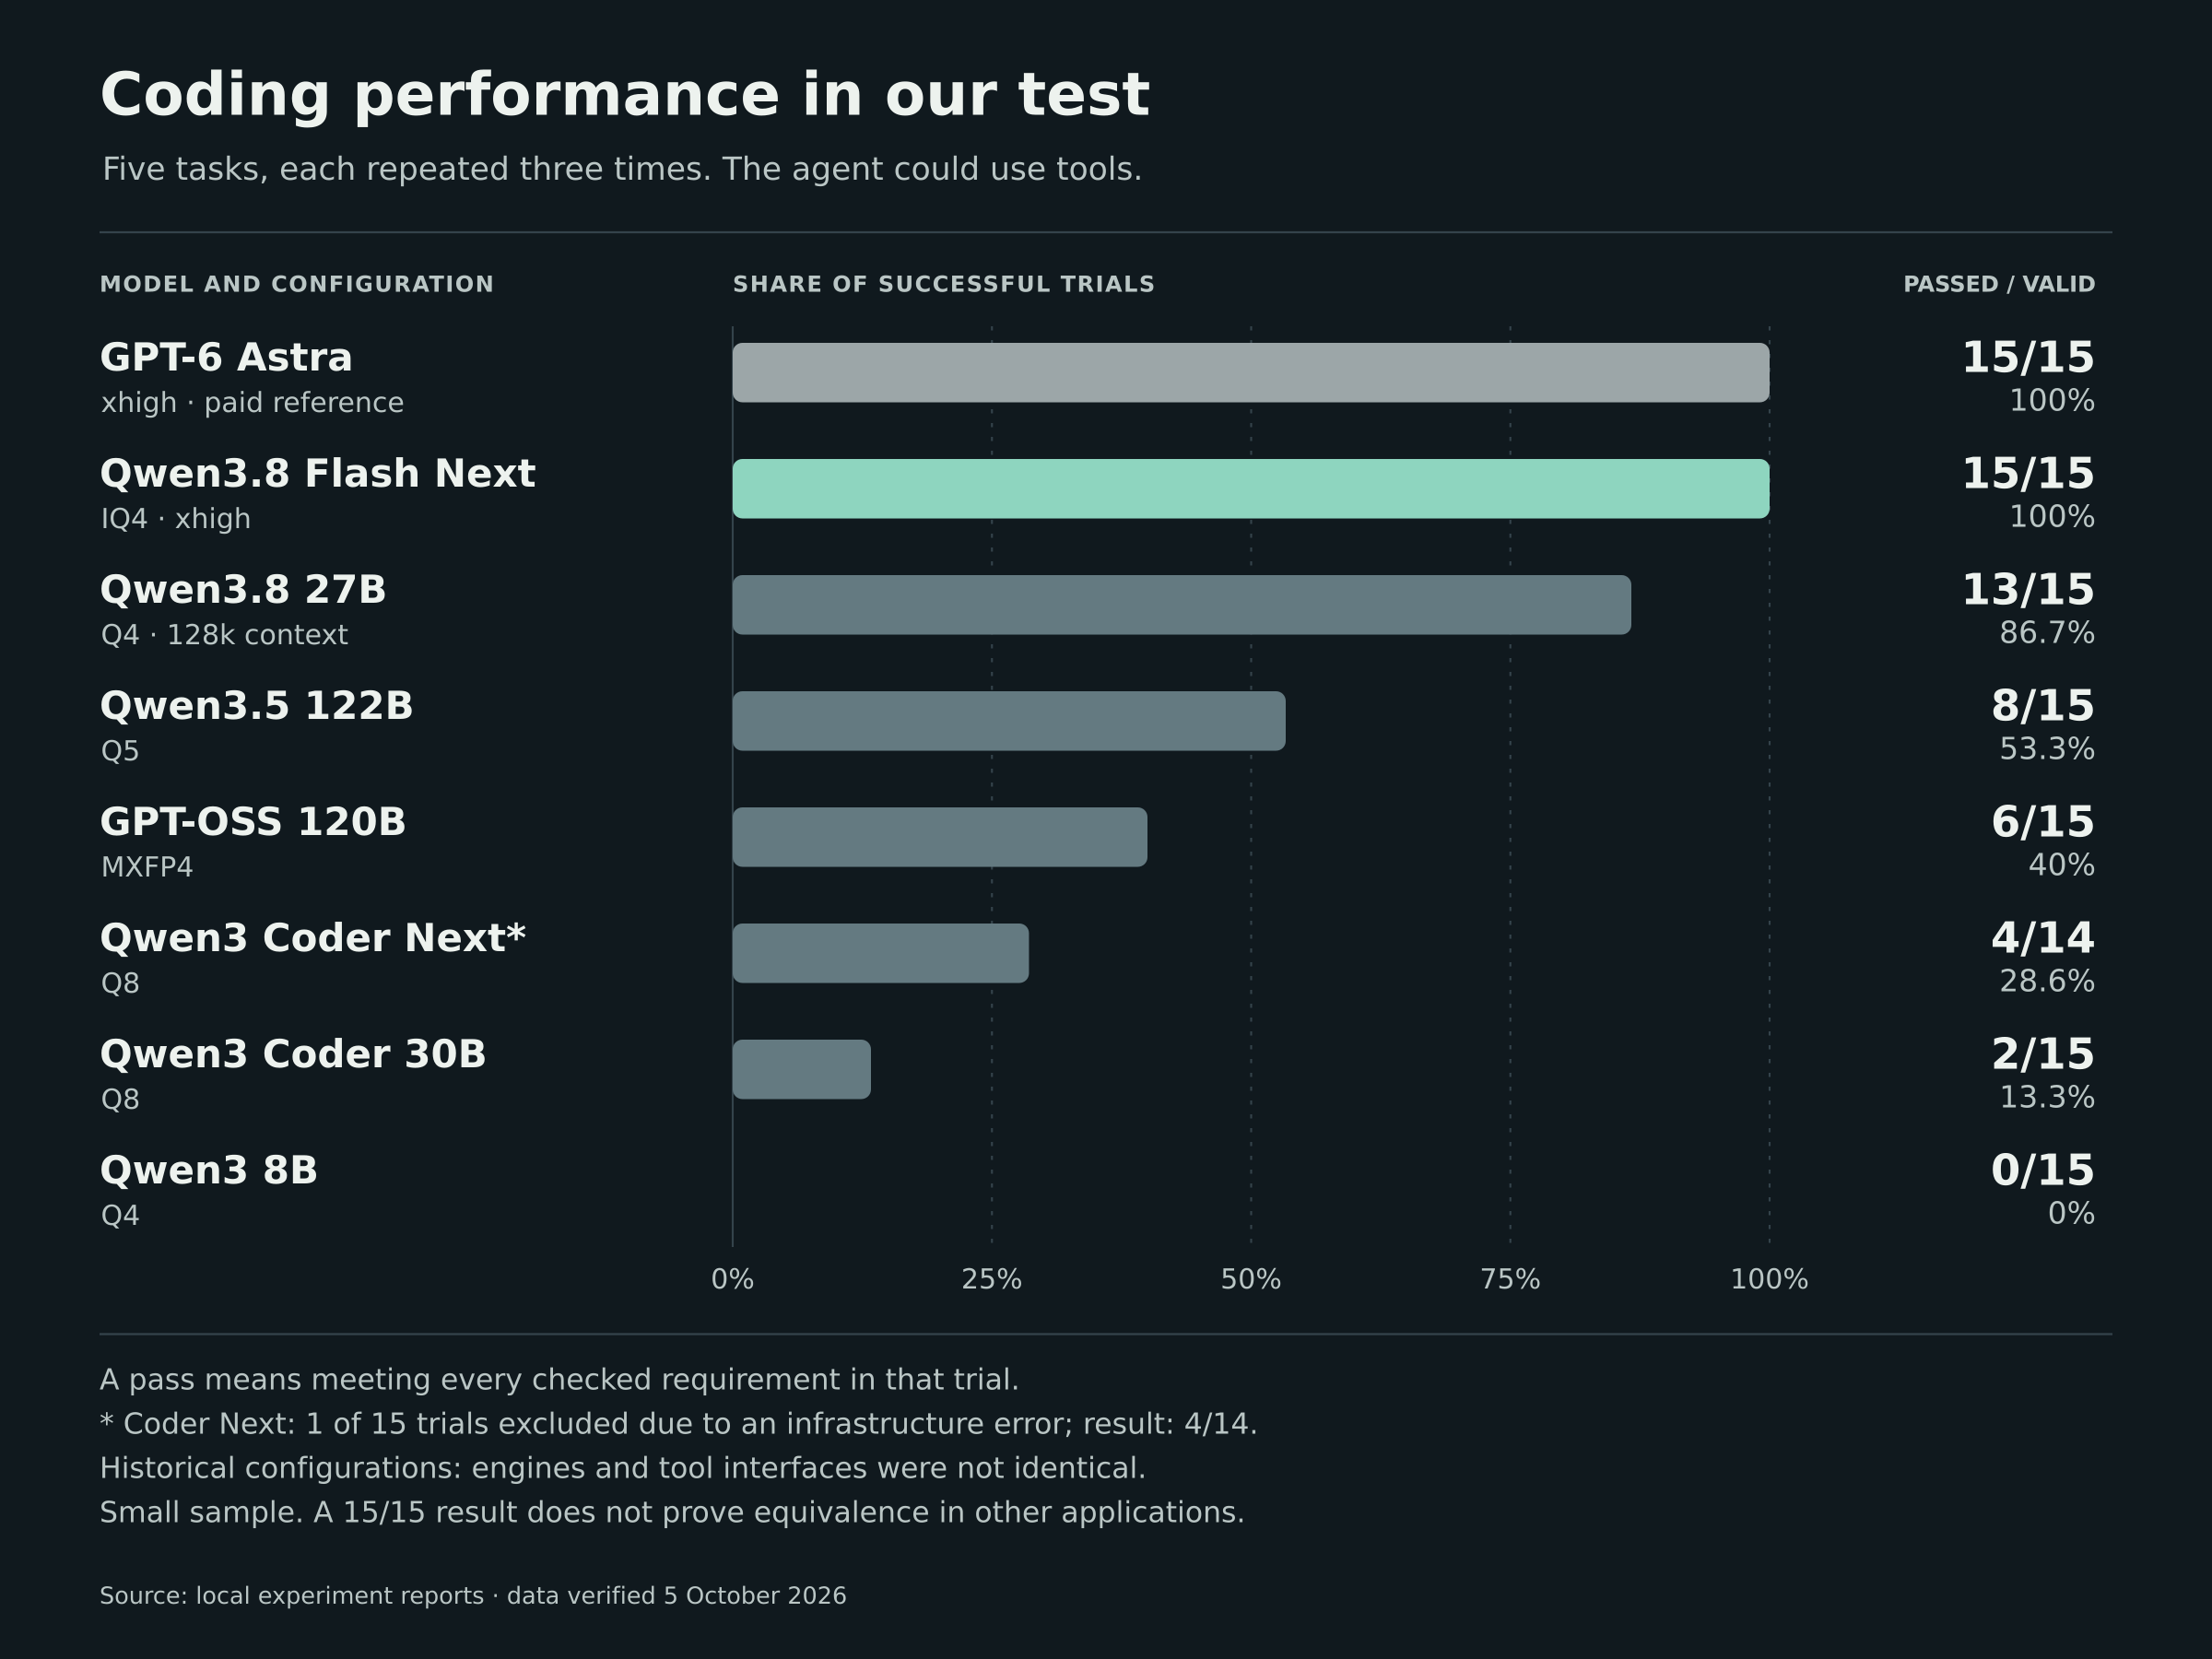
Astra und Flash Next im xhigh-Modus erzielten jeweils 15/15. Am nächsten kam Qwen3.8-27B Q4 mit 128k Kontext und 13 vollständig bestandenen Versuchen von 15. Das deutlich größere Qwen3.5-122B Q5 erreichte 8/15. Die anderen getesteten Konfigurationen hatten bei diesem Satz geringere Erfolgsquoten.
Diagrammergebnisse als Tabelle
| Modell und Konfiguration | Bestanden / gültige Versuche | Erfolgsquote |
|---|---|---|
| GPT-6 Astra · xhigh | 15/15 | 100% |
| Qwen3.8 Flash Next · IQ4 · xhigh | 15/15 | 100% |
| Qwen3.8 27B · Q4 · 128k | 13/15 | 86.7% |
| Qwen3.5 122B · Q5 | 8/15 | 53.3% |
| GPT-OSS 120B · MXFP4 | 6/15 | 40% |
| Qwen3 Coder Next · Q8 | 4/14 | 28.6% |
| Qwen3 Coder 30B · Q8 | 2/15 | 13.3% |
| Qwen3 8B · Q4 | 0/15 | 0% |
Ein Infrastrukturfehler bei Coder Next wurde ausgeschlossen: Ergebnis 4/14. Historische Konfigurationen verwendeten unterschiedliche Engines und Werkzeugschnittstellen. Die kleine Stichprobe belegt keine Gleichwertigkeit in anderen Anwendungen.
GPT-OSS-120B erreichte 6/15, Qwen3-Coder-Next Q8 bestand 4/14 gültige Versuche und Qwen3-Coder-30B Q8 erreichte 2/15. Qwen3-8B Q4 bestand keinen seiner 15 Versuche vollständig. Der fünfzehnte Versuch von Coder Next wurde wegen eines Infrastrukturfehlers ausgeschlossen; wir werteten ihn nicht als mangelnde Modellfähigkeit. Weder der Name „Coder“ noch eine höhere Parameterzahl garantierten in unserem Ablauf einen Vorteil.
Auch zeitlich lag Flash nahe an Astra. Die mediane Sitzungsdauer betrug etwa 4 Minuten und 24 Sekunden gegenüber 4 Minuten und 16 Sekunden bei Astra. Darin enthalten waren Änderungen, Befehle und der Weg bis zum Abschluss. Eine anfängliche Nachricht wie „Ich prüfe die Dateien“ bedeutete nicht, dass die Lösung fertig war. Bei einem so kleinen Aufgabensatz sind acht Sekunden Unterschied kein belastbarer Beleg für einen Geschwindigkeitsvorteil.
Der Median ist der mittlere Wert der sortierten Versuchszeiten; bei einer geraden Ergebniszahl der Mittelwert der beiden mittleren Werte. Er hilft, eine typische Dauer zu beschreiben, garantiert aber keine Wartezeit für beliebige Aufgaben.
Was zählt neben korrektem Code?
Nutzer müssen wissen, was geändert wurde, warum und welche Tests tatsächlich liefen. Wir bewerteten Erklärungen separat anhand der Antworten, Codeänderungen und aufgezeichneten Befehle. In der früheren Reihe erreichte Flash durchschnittlich 7.7/10 und Astra 10/10. Die Bewertungen von Flash bemängelten unter anderem übermäßige Länge und Aussagen über umfangreichere Prüfungen, als die Nachweise hergaben.
Dies war eine ergänzende KI-Bewertung aus derselben Familie wie das Referenzmodell. Modellnamen wurden vor dem Prüfer verborgen; es gab jedoch weder eine unabhängige menschliche Prüfung noch eine Bestätigung identischer Prüfer-Versionen in beiden Reihen. 10/10 bedeutet die Erfüllung eines bestimmten Bewertungsschemas, nicht die Unfehlbarkeit von Astra. Bewertet wurden sichtbare Erklärungen und Nachweise, ohne verborgene Denkprozesse zu untersuchen.
Wie viel Speicher benötigte Flash Next?
VRAM ist der Grafikkartenspeicher, RAM der Arbeitsspeicher des Servers. Unsere Messungen verwenden GiB, eine Einheit, die sich vom dezimalen GB technischer Daten unterscheidet.
Flash Next verwendete das Format IQ4_NL und 128k Kontext. In der früheren Reihe erreichte die GPU-Speicherspitze 72.9 GiB und ließ damit etwa 22.7 GiB Reserve bezogen auf die vom Treiber gemeldete Kapazität. Die Messung erfasste den Betrieb des Modellservers einschließlich Vorbereitung und Tests mit jeweils einer Sitzung.
Alle Transformer-Schichten und der Kontextcache lagen auf der GPU. Einige Embeddings, also Tabellen zur Darstellung von Textbausteinen, nutzten Server-RAM. Laut der Modellkarte des Herausgebers hat Flash Next einen Kern mit 125 Milliarden Parametern, ungefähr 6 Milliarden während der Berechnung aktive Parameter und weitere 51 Milliarden Embedding-Parameter. Die aktive Parameterzahl beschreibt nicht die Größe des gesamten zu speichernden Modells.
Was kann ein lokales Modell einem Unternehmen bieten?
Ein lokales Modell ermöglicht es einem Unternehmen, Code, Dokumente, Fragen und generierte Ergebnisse in der eigenen Umgebung zu halten, ohne sie an eine externe Modell-API zu senden. Für interne Analysen kann das die Kontrolle über Verarbeitungsort und Zugriffsrechte erleichtern.
Das Unternehmen kann Zugriffsrechte, Protokollierungsregeln und Aufbewahrungsfristen festlegen. Es kann auch die Modellversion auswählen und über Aktualisierungen entscheiden. Das hilft, wiederkehrende Aufgaben konsistent auszuführen und Änderungen vor dem Alltagseinsatz zu prüfen.
Voraussetzung ist, dass der gesamte Ablauf lokal bleibt. Anwendungen, Integrationen, Telemetrie und Backups dürfen die betreffenden Daten nicht aus dem Unternehmen übertragen. Nach Vorbereitung von Modell, Software und nötigen Dateien kann die Arbeit auch offline fortgesetzt werden, sofern kein Teil der Aufgabe von einem externen Dienst abhängt.
Das gibt dem Unternehmen mehr Kontrolle über die Datenverarbeitung; es garantiert nicht, dass Datenlecks ausgeschlossen sind. Ebenso bedeutet die Nutzung eines externen Dienstes nicht, dass Daten öffentlich werden.
Das Unternehmen muss weiterhin das System einrichten und betreuen, Speicher und Strom bereitstellen sowie Zugriffe verwalten. Unsere Tests berechneten weder Gesamtbetriebskosten noch eine Rentabilitätsschwelle gegenüber einem Abonnement.
Liefert eine höhere Einstellung ein besseres Ergebnis?
Nach dem ersten Vergleich erstellten wir sechs neue Aufgaben und weitere 72 Versuche. Flash Next lief mit den Einstellungen xhigh und medium; Qwen 27B wurde in den Varianten Q4 und Q8 getestet. Jede Konfiguration erhielt 18 Versuche. Astra nahm an dieser Reihe nicht teil. Sein früheres 15/15 ist deshalb kein Ergebnis desselben Tests wie diese neuen Werte.
| Konfiguration | Vollständig erfolgreiche Versuche | Mediane Sitzungsdauer |
|---|---|---|
| Flash Next medium | 18/18 | 2 min 42 s |
| Flash Next xhigh | 18/18 | 3 min 17 s |
| Qwen 27B Q4 xhigh | 18/18 | 5 min 14 s |
| Qwen 27B Q8 xhigh | 18/18 | 6 min 40 s |
Die mediane Zeit von Flash medium war etwa 18% kürzer als bei xhigh, bei gleicher Anzahl erfolgreicher Versuche. Geändert wurde der Reasoning-Aufwand, nicht die Modellgröße. Q8 verbesserte die Erfolgsquote gegenüber Q4 nicht; sein Median war etwa 27% länger. Q4 und Q8 liefen in aufeinanderfolgenden Blöcken, was die Interpretation der Zeiten begrenzt. Jede Konfiguration bestand alles: Für weitere Unterschiede in der Korrektheit werden schwierigere Aufgaben benötigt.
Was ändert ein höheres Tokenlimit?
Ein Token ist ein Textbaustein: ein Wort, Wortteil oder Zeichen. Das Generierungslimit legt das Budget für die Antworterzeugung fest. Es unterscheidet sich vom Kontext, der die Kapazität für das vom Modell verarbeitbare Material bestimmt.
Separat testeten wir Code aus einer einzigen Antwort, ohne dem Modell Datei- oder Testausführung zu erlauben. Bei einem Limit von 16k Tokens erreichte Flash 0/6, bei 32k 2/6 und bei 64k 4/6. Qwen 27B erreichte entsprechend 1/6, 3/6 und 4/6. Die Ergebnisse waren schwächer als beim Arbeiten als Agent mit Werkzeugen.
Das Limit umfasste auch Reasoning-Tokens. Manchmal war es ausgeschöpft, bevor sichtbarer Code erschien. Ein größeres Budget half, doch Abbrüche und Fehler blieben. Wir testeten nur zwei Aufgaben; außerdem stieg das Zeitlimit zusammen mit dem Tokenbudget. Das Ergebnis lässt sich weder allein der Tokenzahl zuschreiben noch auf sämtliche Programmierarbeit verallgemeinern.
Kostenloses Modell, kostenpflichtiger Dienst: Gleichstand in unserem Test
Qwen Flash Next und GPT-6 Astra erzielten beide 15/15 bei fünf Aufgaben mit je drei Wiederholungen. Das ist ein Gleichstand vollständig erfolgreicher Versuche in unserem Aufgabensatz. In der ergänzenden KI-Prüfung erhielt Astra für Erklärungen die höhere Bewertung.
Ein kostenlos herunterladbares Modell muss nicht schlechter abschneiden als ein kostenpflichtiger Dienst. Die Gewichte von Flash Next sind ohne Downloadgebühr unter der Lizenz des Herausgebers erhältlich; Infrastruktur und Betrieb kosten weiterhin Geld.
Für einen eigenen Vergleich sehen Sie sich das Serverangebot von GPU Server Hub an.
Ergebnisquelle: eigene Tests vom 29. September bis 5. Oktober 2026. Die Daten behandeln die ursprüngliche Programmierreihe, den späteren Vergleich von vier Konfigurationen und das Experiment zum Generierungsbudget getrennt. Hauptillustration: KI-generiert. Diagramm: auf Grundlage aufgezeichneter Ergebnisse.